La verificación de texto…

Si es aficionado al mundo bloguero y además comenta de vez en cuando los posts, seguro que ha visto ésto más de una vez:

Como posiblemente sepa, la verificación de palabra sirve para que nadie pueda enviar publicidad, utilizando programas que manden comentarios de forma automática… ¿el truco? que sólo un humano podrá reconocer texto en esa imagen distorsionada. Es una consecuencia directa de lo que nos diferencia de los ordenadores…

Sin embargo, esto no está tan claro… la idea funciona bien en la práctica, pero con cierto esfuerzo se puede hacer que los ordenadores reconozcan texto. Por ejemplo, pongamos que escribimos un «2» de nuestro puño y letra:
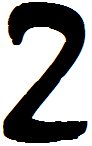
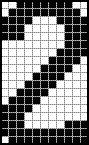
¿Sí? Un bonito y gran número. Ahora pensemos en un ordenador que almacena este 2 en memoria y le superpone una cuadrícula, así:

Parece ridículo, pero acabamos de dar un gran salto: en este momento un ordenador ya puede tratar este número, no como un trazo, sino como una tabla donde una casilla puede tomar dos valores: blanco o negro (0 ó 1… qué curioso :P). Ahora, pongamos que el ordenador tiene grabado el siguiente gráfico en su memoria (y que tiene también la «tabla» con el valor de cada casilla)

Hasta aquí no hemos hecho magia… quizá el paso más complicado es que el ordenador lea la imagen original y construya la tabla con el color de cada casilla… pero es bien posible, se lo aseguro. El siguiente paso es fantástico:

compa.jpg

Bueno, no es tan fantástico, pero ¿se imaginan qué podemos hacer ahora? Comparemos las dos tablas que tenemos en memoria, con las casillas que están a negro o a blanco… Bien, no van a coincidir todas, pero quizá sí el 80%… y si hacemos los cuadros muy muy pequeños podremos tener aun más precisión. Luego lo único que nos faltaría es hacer una comparación entre las tablas utilizando estadística… y eso sí lo sabe hacer el ordenador :)Así que nuestro estúpido armatoste de silicio terminará comprendiendo que eso que alguien escribió es, efectivamente, un «2»… Con esto tal vez pueda hacerse una idea de lo extremadamente estúpidos que son los ordenadores si los comparamos con un humano…

¿Y qué pasa entonces con la verificación de palabra? Pues fíjese atentamente en la imagen que pusimos como ejemplo antes:
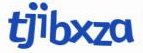
Las letras están retorcidas y en contacto para despistar al ordenador. Es todo extremadamente sutil: para diferenciar las letras como la ‘t’, la ‘j’ y la ‘i’, podríamos recortar valiéndonos de los espacios en blanco, pero entonces no sabríamos separar la ‘b’, la ‘x’, la ‘z’ y la ‘a’… cualquier programa informático se haría un verdadero lío con estos trucos tan infantiles. Si no se lo cree compruébelo.

Este tipo de tecnología ha sido ampliamente estudiada, por ejemplo, para el reconocimiento de texto de los escáneres con tecnología OCR (Reconocimiento óptico de caracteres). Hoy en día no lo hacen nada mal, siempre que no se les líe a conciencia ;-)

El portátil de los cien dólares

Es, desde mi punto de vista, una de esas ideas fantásticas que tiene la humanidad y que nos dejan ser optimistas… En esta ocasión se trata de este proyecto, dirigido por Nicholas Negroponte. No podría resumir aquí quién es Negroponte ni dar una idea de la influencia de su figura en el mundo de las tecnologías… toda una personalidad…

laptop-crank.jpg

Negroponte, como digo, está al frente del proyecto OLPC (One Laptop per Child). Esta organización ha logrado diseñar un portátil (más bien lo que se viene denominando tablet PC) que tiene como objetivo costar menos de 100 dólares, para que todo lo positivo de la tecnología llegue a todos los rincones de la tierra… El ordenador tiene un diseño compacto y muy versátil, y lo que es más sorprendente: una manivela (se entiende que así podrá ser utilizado sin electricidad)

laptop-theater1.jpg

laptop-theater.jpg

Quizá a algún lector le extrañe mi euforia con el asunto, pero es que pienso que el hecho de que alguien consiga desarrollar un equipo funcional por menos de 100$ tendrá una repercusión muy positiva en todo el mundo… Además, soy un incondicional de Negroponte :-) Es un ejemplo a seguir…

¿Internet o carretera?

Ayer comentaba las diferencias entre el cerebro y un ordenador… hoy toca otra entrega de comparaciones extrañas pero curiosas…

Ignoro si alguna vez se ha planteado usted lo que voy a exponer… pero puede ser que Internet no sea tan rápido y tan maravilloso… Seguramente, usted se conecte a 56 Kbps con una línea telefónica convencional, o a cierta cantidad de megas (Mbps) a través de una ADSL. Hay más sistemas, pero hoy en día, prácticamente todo el mundo utiliza uno de estos dos…

carretera.jpg

Bien, imaginemos que quien anuncia 20 Mbps pudiera, efectivamente, proporcionarlos. Antes de nada, decir que son 20 Megabits por segundo y no 20 Megabytes por segundo. La diferencia es sutil pero importante: 1 Byte = 8 bits (la ‘B’ mayúscula se usa para el Byte y la ‘b’ minúscula para el bit, de modo que 1B = 8b*). Cuando nos dicen 20 «Megas por segundo» podemos pensar que son 20 Megabytes por segundo, pero en realidad sólo son 20 Megabits por segundo… 20/8 = 2,5; con lo cual nos quedamos en 2,5 Megabytes por segundo (2,5 MBps, con la M mayúscula)

Aclarado esto, tenemos nuestro ordenador con nuestra línea de 2,5 MBps. Suponemos que la compañía nos da todo lo que pagamos, lo cual es mucho suponer (sólo está obligada a proporcionar el 10% de lo contratado)

Imaginemos que quiero transmitir una copia de mis ficheros de Salamanca a Santander (365 Km.) y que todos mis ficheros ocupan 100 Gigabytes. No es descabellado, los bancos hacen este tipo de operaciones a menudo para garantizar la seguridad de sus datos, y los volúmenes transferidos pueden ser de Terabytes (1 TB = 1024 GB)

Con mi línea ADSL puedo transferir 2,5 Megabytes cada segundo, así que 100 GB = 102.400 Megabytes. Tardo algo más de 11 horas en transferir todo (suponiendo que no se cometen errores). Ahora imagine que copio los 100 GB en 25 DVD (1 DVD = 4 GB más o menos), los meto en el maletín y los llevo a Santander con el coche. Suponiendo que viajo a una media de 100 Km/h, lo cual implica respetar los límites de velocidad, tardo algo menos de 4 horas… ¿qué ha pasado?

Simplemente sucede que para grandes cantidades de datos, es más eficiente el transporte físico que la transferencia a través de redes… Sin embargo, llevar las copias en coche tampoco es lo mejor, porque el tiempo de respuesta es muy elevado. Si hubiera que hacer algún cambio o hubiera un error (o incluso el del coche se matara por el camino) sería necesario volver a enviarlo todo. Además, hay que grabar los DVD y poner gasolina al coche… No obstante, la lección es dramática: no subestime nunca el poder de un coche cargado de discos.

* Para los puristas, 1 byte no siempre es igual a 8 bits, pues depende de la plataforma y del equipo que utilicemos. No obstante, esta equivalencia es la más habitual…

El hombre contra la máquina

Tal vez en alguna ocasión se haya preguntado qué nos diferencia de los ordenadores en nuestra forma de pensar que nos hace tan especiales a unos y a otros… Los grandes ordenadores actuales tienen una enorme potencia y una velocidad que hace sólo unos años era inconcebible… aunque, como decíamos en este artículo, máquinas son y máquinas serán…

homer_cerebro.jpgSintiéndolo mucho por los ordenadores, el más estúpido de los humanos es más inteligente que el mejor computador. Aunque no estemos siendo muy justos. Por ejemplo, somos mucho mejores que las máquinas realizando trabajos abstractos, como reconocer patrones y todos los que se nos plantan en los tests de inteligencia.

Por ejemplo, en la sucesión 2, 4, 6, 8, 10… rápidamente vemos que cada número es el anterior más 2, pero a un ordenador le costaría bastante más: si le diéramos varias sucesiones con un incremento cualquiera no podría en principio reconocer la forma general, salvo utilizando tanteo. La cuestión es que quizá el ordenador tarde menos en dar la respuesta por tanteo que nosotros intuitivamente…

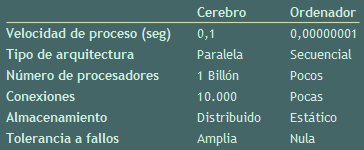
Decía más arriba que no es muy justo porque, en sentido estricto los ordenadores no están dotados de inteligencia tal y como la conocemos, aunque hay avances muy interesantes sobre ésto. Si nos rebajamos un poco y planteamos nuestro cerebro como un tipo de sistema computacional (que nadie se rasgue las vestiduras) veremos que hay diferencias muy interesantes:

tabla_ia7.jpg

En la tabla anterior hay conceptos, como la arquitectura, que son términos heredados de la informática. Los ordenadores sólo pueden ejecutar una instrucción en cada instante de tiempo, aunque tengamos la ilusión de hacer muchas cosas a la vez… Sin embargo nosotros podemos cantar a la vez que escuchamos música, trabajamos con el ordenador y bebemos café (propia experiencia).

El número de procesadores quiere simbolizar la cantidad de elementos de cálculo. En nuestro cerebro acumulamos del orden de varios cientos de miles de millones de neuronas (incluso billones). Sin embargo los ordenadores sólo tienen, a lo sumo unas cuantas decenas de procesadores. En el caso de los PC, tienen sólo uno (aunque se pueden comprar con varios). Con este esquema, el cerebro humano puede tener varios miles de conexiones frente a las pocas que tiene un ordenador medio.

El almacenamiento es otro punto interesante. En los computadores convencionales se realiza en memoria volátil y en memoria persistente, según interese conservar los datos. El cerebro humano distribuye el almacenamiento en diferentes áreas, lo cual le hace ser mucho más resistente ante los fallos… Los accidentes pueden producirnos amnesias parciales algunas de las cuales pueden incluso recuperarse. Sin embargo, el almacenamiento computacional es enormemente delicado. Acerque un imán a un disquete, pase una lija sobre un CD… ¿se imagina que nos sucediera lo mismo? :-P

El tema de la inteligencia es muy controvertido y sin duda seguirá dando que hablar durante muchos años… Pero habrá cosas que seguiremos haciendo mejor que ellos, de la misma forma que los computadores se mueven con soltura en terrenos en los que somos manifiestamente torpes, como la simulación, el cálculo matemático, el procesamiento de grandes cantidad de datos…

Un ordenador no habría sido capaz de escribir esta entrada sin una mente diciéndole que tiene que hacer (aunque yo no lo habría publicado jamás de no ser por él…) Qué mundo éste, ¿eh?

El verdadero nombre las cookies

Es increible como uno siempre aprende algo nuevo… un amable lector nos enviaba el siguiente comentario al anterior post sobre las cookies:

[…] Las cookies son esas tarjetas que te dan como recordatorio en los guardarropas de Londres. Besos a todos y todas

De modo que, en contra de lo que se suele leer, el término cookie no proviene de galleta como comentábamos en nuestro anterior post (es curioso, pero ahora que lo se, me pregunto por qué diablos me creí lo de la galleta… qué cosas…) No obstante, me da pena quitar a mi idolatrado monstruo de las galletas del post original, y la red está llena de maravillosas alegorías como ésta:

cookie-ch.jpg

Aclarado esto, quisiera dar las gracias a nuestro anónimo y amable colaborador… y es que me maravillan estas cosas :-) Tras algunas investigaciones, parece que el origen y la traducción del término cookie no están nada claros… ¡se admiten nuevas propuestas!

Aclarado esto, quisiera dar las gracias a nuestro anónimo y amable colaborador… y es que me maravillan estas cosas :-) Tras algunas investigaciones, parece que el origen y la traducción del término cookie no están nada claros… ¡se admiten nuevas propuestas!

La invasión de las cookies asesinas

Un nombre inocente, ¿verdad? Las cookies forman parte indisoluble de nuestra existencia, aunque muchos seguimos prefiriendo las galletas de toda la vida ;-)

trikifriki.jpg¿Qué es una cookie? Una «cookie» (galleta o tarta en inglés). [Actualización: esto no es del todo correcto…] no es más que un ficherito de texto que una página web puede almacenar en nuestro equipo. ¿Por qué? Pues empecemos diciendo que hasta hace unos años, la navegación era completamente estática: las páginas web mostraban información y el mayor grado de interactividad existente consistía en los clics del ratón sobre los hipervínculos… saltar de un documento a otro.

Con la popularización de Internet, las páginas web comenzaron a demandar más funcionalidad. Una parte de esa funcionalidad es la interactuación con el usuario: se mejoró el diseño, apareció la animación, el flash… Otra parte es el almacenamiento: muchas veces se hace necesario almacenar contraseñas, preferencias de visualización… Sobre esto último, el almacenamiento puede hacerse en dos sitios: en el servidor (donde está almacenada la web) o en el cliente (el que está viendo la web)

En el servidor se almacenan algunos datos críticos: nombres de usuario, contraseñas, datos personales, etc. Sin embargo, hay otros datos poco importantes que se almacenan en el cliente: el color elegido para el fondo de la web, la última búsqueda, si ya ha votado en tal o cual encuesta… este tipo de cosas. Ahora podemos preguntarnos: ¿por qué no en el servidor? Por que no parece óptimo que un servidor acumule gran cantidad de información sobre visitantes que quizá no regresen nunca… evidentemente, la solución a esto ha sido almacenar estos datos en el cliente. ¿Cómo? ¡Usando cookies! ¡Premio!

Con este panorama, y la creciente popularización de las cookies, pronto surgió una leyenda negra… imagine, ¡cualquier servidor puede escribir en nuestro ordenador! Sin embargo, hay que decir que estos ficheros apenas entrañan riesgos: estas galletas son texto plano e inofensivo. Sí que podría utilizarse en ciertas condiciones para ejecutar código en nuestro ordenador, pero esto es tan complicado (sobre todo si se usa Firefox) que no merece mucha consideración… (bueno, puedo dejarlo para otra entrega en modo experto)

De modo que, querido lector, puede dormir tranquilo: entre todas las posibilidades de intrusión de las que probablemente dispondría cualquier atacante, no figuran estas galletitas. Realmente existen muy pocos riesgos reales derivados de las cookies, y en cualquier caso, sólo representan un riesgo en su privacidad, nunca en la seguridad de su sistema.

Existe mucho software que permite gestionar y borrar las cookies. Los mismos navegadores lo permiten con relativa sencillez. Yo recomiendo el Norton Advanced Cleanup, que tiene esta pinta:

kukis.jpg

Espero haber aclarado algunos conceptos sobre estas sospechosas aunque honradas amigas que son las cookies :-) ¡Tenga una navegación segura!

Deprímase: El límite computacional

Vamos a imaginar una extraña máquina… una máquina que consta de simplemente de una cinta de papel y un cabezal que sea capaz de hacer estas tres acciones:

  • Moverse una posición a la derecha o a la izquierda
  • Leer un caracter
  • Escribir un caracter

Parece sencillo, ¿no? Esta máquina se conoce como Máquina de Turing, en honor a su creador, Alan Turing. Y es bastante sencillo construir una. Hay quien ha optado por el Lego, aunque también podemos simular una con papel y lápiz…

Ahora agárrese a la silla: esa máquina inocente puede hacer exactamente lo mismo que su potente ordenador. Dicho de otro modo más impactante: no podrá hacer nada con su ordenador que yo no pueda hacer con mi máquina de Turing.

Piense en algo que pueda hacer con su equipo, lo más complicado… puedo jurarle que la máquina de Turing puede hacerlo. Probablemente más despacio, pero lo hará… ¿Se lo imagina? Esto no es vudú ni magia negra, sino que se debe al hecho (dramático) de que un ordenador no es más que una máquina de Turing.

mt.jpg

Si queremos una explicación más detallada, tenemos que entender que los ordenadores no son más que unos dispositivos que computan, esto es, que calculan cosas a partir de otras cosas. Dibujar algo en una pantalla no es una tarea complicada para un ordenador, en absoluto… sus problemas vienen cuando se trata de realizar operaciones o decidir sobre problemas… de hecho, si pudieramos meter en una bolsa todos los problemas del universo, veríamos que los ordenadores sólo son capaces de resolver unos pocos… Otro día comentaré algunos problemas que los computadores convencionales jamás podrán solucionar…

El panorama es un poco deprimente… mi potente equipo no puede hacer nada que no pueda hacer la máquina de Lego que comentaba antes… esto, en teoría de computación se conoce como el «límite computacional», que delimita esa pequeña porción de problemas en los que los ordenadores se sienten cómodos… Este límite no ha cambiado, ni cambiará… los ordenadores son capaces de resolver problemas que antes no podían resolverse en un tiempo razonable, pero no hacen nada ahora que no pudieran hacer antes.

Alan Turing postuló que el poder de su máquina llegaba hasta el mismo límite computacional. Y parece que no se equivocó…

Consultorio SF (I) Las redes inalámbricas

Una simpática lectora (¡gracias, Misslucifer!) nos envía esta consulta:

¿Qué alcance tiene una red inalámbrica? Es decir, ¿si yo tuviera la mía desprotegida podrían mis vecinos que viven a nosecuantos metros parasitarme?

Actualmente, lo habitual es que las redes inalámbricas consten de una serie de ordenadores formando una Red de ?rea Local (LAN) y un router conectado a una línea ADSL. Todos los equipos que conectamos al router para compartir la conexión, tienen su tarjeta inalámbrica, y a través de ella consiguen conectarse al router.

Un router es una especie de pasarela que comunica nuestra red interna con Internet. Así, podemos tener dos o tres ordenadores en red (para poder compartir los archivos, por ejemplo) conectados al router. El router hace un poco de cruce de carreteras: todos los ordenadores pasan por él para comunicarse con el resto… También puede ser que tengamos una red inalámbrica sin salida a Internet, sencillamente una red local por ondas.

wifiseguro.jpgBueno, ahora que sabemos un poco más de lo que hablamos, podemos entrar en consideraciones más complicadas. Si yo comunico dos ordenadores por cable, a no ser que alguien «pinche» físicamente el cable, la comunicación no puede ser interceptada. El problema viene de la conexión inalámbrica… y es que el aire es de todos… Así, no nos extraña que las redes inalámbricas tengan un problema tan serio en cuanto a la seguridad.

Una conexión inalámbrica puede cifrarse y protegerse con contraseña. El problema es que hoy por hoy, se utiliza el protocolo de cifrado WEP, que puede romperse con cierta facilidad. Sin embargo, ese no es el problema. El problema es que un gran número de las redes que se instalan se instalan «abiertas», esto es, sin cifrado y sin clave de acceso. Esto puede resultar muy cómodo al técnico de la compañía, que nos evita las preocupaciones al tiempo que se las evita él. La gente olvida las contraseñas, y tarde o temprano tendrán problemas, y llamarán al servicio técnico… no interesa.

El otro caballo de batalla, y ahora respondo a la pregunta, es el alcance. Una red convencional tiene un alcance que varía entre 20 y 200 metros, en función de si hay obstáculos (paredes, árboles..) y de la calidad de los dispositivos que utilicemos. En el campo esto no representa un gran problema, pero en las ciudades no podemos limitar nuestra red a nuestro edificio o a nuestro piso, así que tendremos que tomar otras medidas. De todos modos, la seguridad nunca está de más, por lo que, aunque pensemos que estamos a salvo, no va a pasar nada por activar el cifrado…

Vivimos en una sociedad con muy poca cultura informática, y ello provoca situaciones como ésta… Los instaladores prefieren ocultar esta parte oscura de la tecnología y persuadirnos de que todo es rosa, para que así contratemos sus servicios… pero eso ya es otra historia…

Consultorio SF

En la línea de nuestro blog favorito, Curioso Pero Inútil, y plagiando una de sus más célebres secciones, el Consultorio CPI, nace esta sección dedicada a resolver toda duda relacionada con la informática que pueda ocurrírsele a nuestros lectores…

Así que ya saben… ¡pregunten! Pueden dirigirse a la dirección de correo que aparece a la derecha de este post.

RSS, el amigo invisible

¿Harto de visitar cada día decenas de blogs para ver si hay cambios? ¡El RSS puede ayudarte! No es una República Socialista Soviética. RSS es el acrónimo de «Really Simply Sindication» (la traducción al castellano es muy lamentable y poco esclarecedora, así que nos la vamos a ahorrar)

En «modo experto» diríamos que el RSS es un formato de archivo derivado del XML. Para los que no les importe tanto este detalle, diremos que el RSS es un tipo de archivo que se utiliza para publicar información de los cambios de ciertos sitios web. O sea, yo hago un cambio en mi web y lo reflejo en un fichero RSS asociado. La cuestión es… ¿para qué?

Pues simplemente porque si me instalo un programa capaz de leer ficheros RSS (los llamados «agregadores») puedo estar al día de todos los cambios de una web que tenga RSS. Y si leo diariamente treinta blogs, me evito darme mil vueltas cada mañana en busca de actualizaciones… mi agregador me dirá en cuáles hay novedades y en muchos casos, me las presentará… ¡así de sencillo!

Si alguien ha entendido estar torpe explicación, puede estar pensando en conseguir uno de estos programas «agregadores». Si usa Firefox (lo cual recomiendo) o Thunderbird, tiene la mitad del trabajo hecho. En Firefox, las páginas con RSS se destacan con este símbolo:

Si hacemos clic sobre el botoncito ese, se agregará un marcador dinámico (podremos consultarlo en el menú «Marcadores», donde lo hayamos insertado). Esta es una opción bastante buena. Pero si tenemos Thunderbird (mucho mejor que el Outlook, al menos más seguro) hay que ir al menú «Archivo – Nuevo – Cuenta». Ahí vamos a seleccionar «RSS News & blogs», ponemos un nombre a la cuenta y luego lo único que tenemos que hacer es agregar la dirección del fichero RSS. Normalmente en los blogs hay siempre un botoncito como este:

Que está enlazado con la dirección del archivo RSS (en este caso el de este blog…) ¡así de sencillo! Si algún purista ha leído esto, quizá se esté tirando de los pelos… este truquillo existía desde hace mucho tiempo, en forma de suscripción XML… pero el fenómeno Blog ha contribuído a popularizarlo… He dicho :)